GOOGLE VEO 3 搭載 • 高速マルチスレッド パイプライン

完全自動化 AI動画制作スタジオ 台本から 映画級4K動画へ一気に昇華

Google Veo 3、AI台本自動シーン分割、感情豊かなスタジオ級音声合成、そして多重並列レンダリングを統合した、プロフェッショナル向けデスクトップ制作環境。

10x
動画制作の高速化
100+
スタジオTTS音声
16+
並列レンダリングスレッド
99.8%
レンダリング成功率
実際のソフトウェア画面

プロフェッショナルな 制作モジュールを体感

稼働中のSeven Media実機画面から直接キャプチャ。台本分割、並列キュー、プロキシ隔離、音声ミキシングまで、すべてネイティブ動作します。
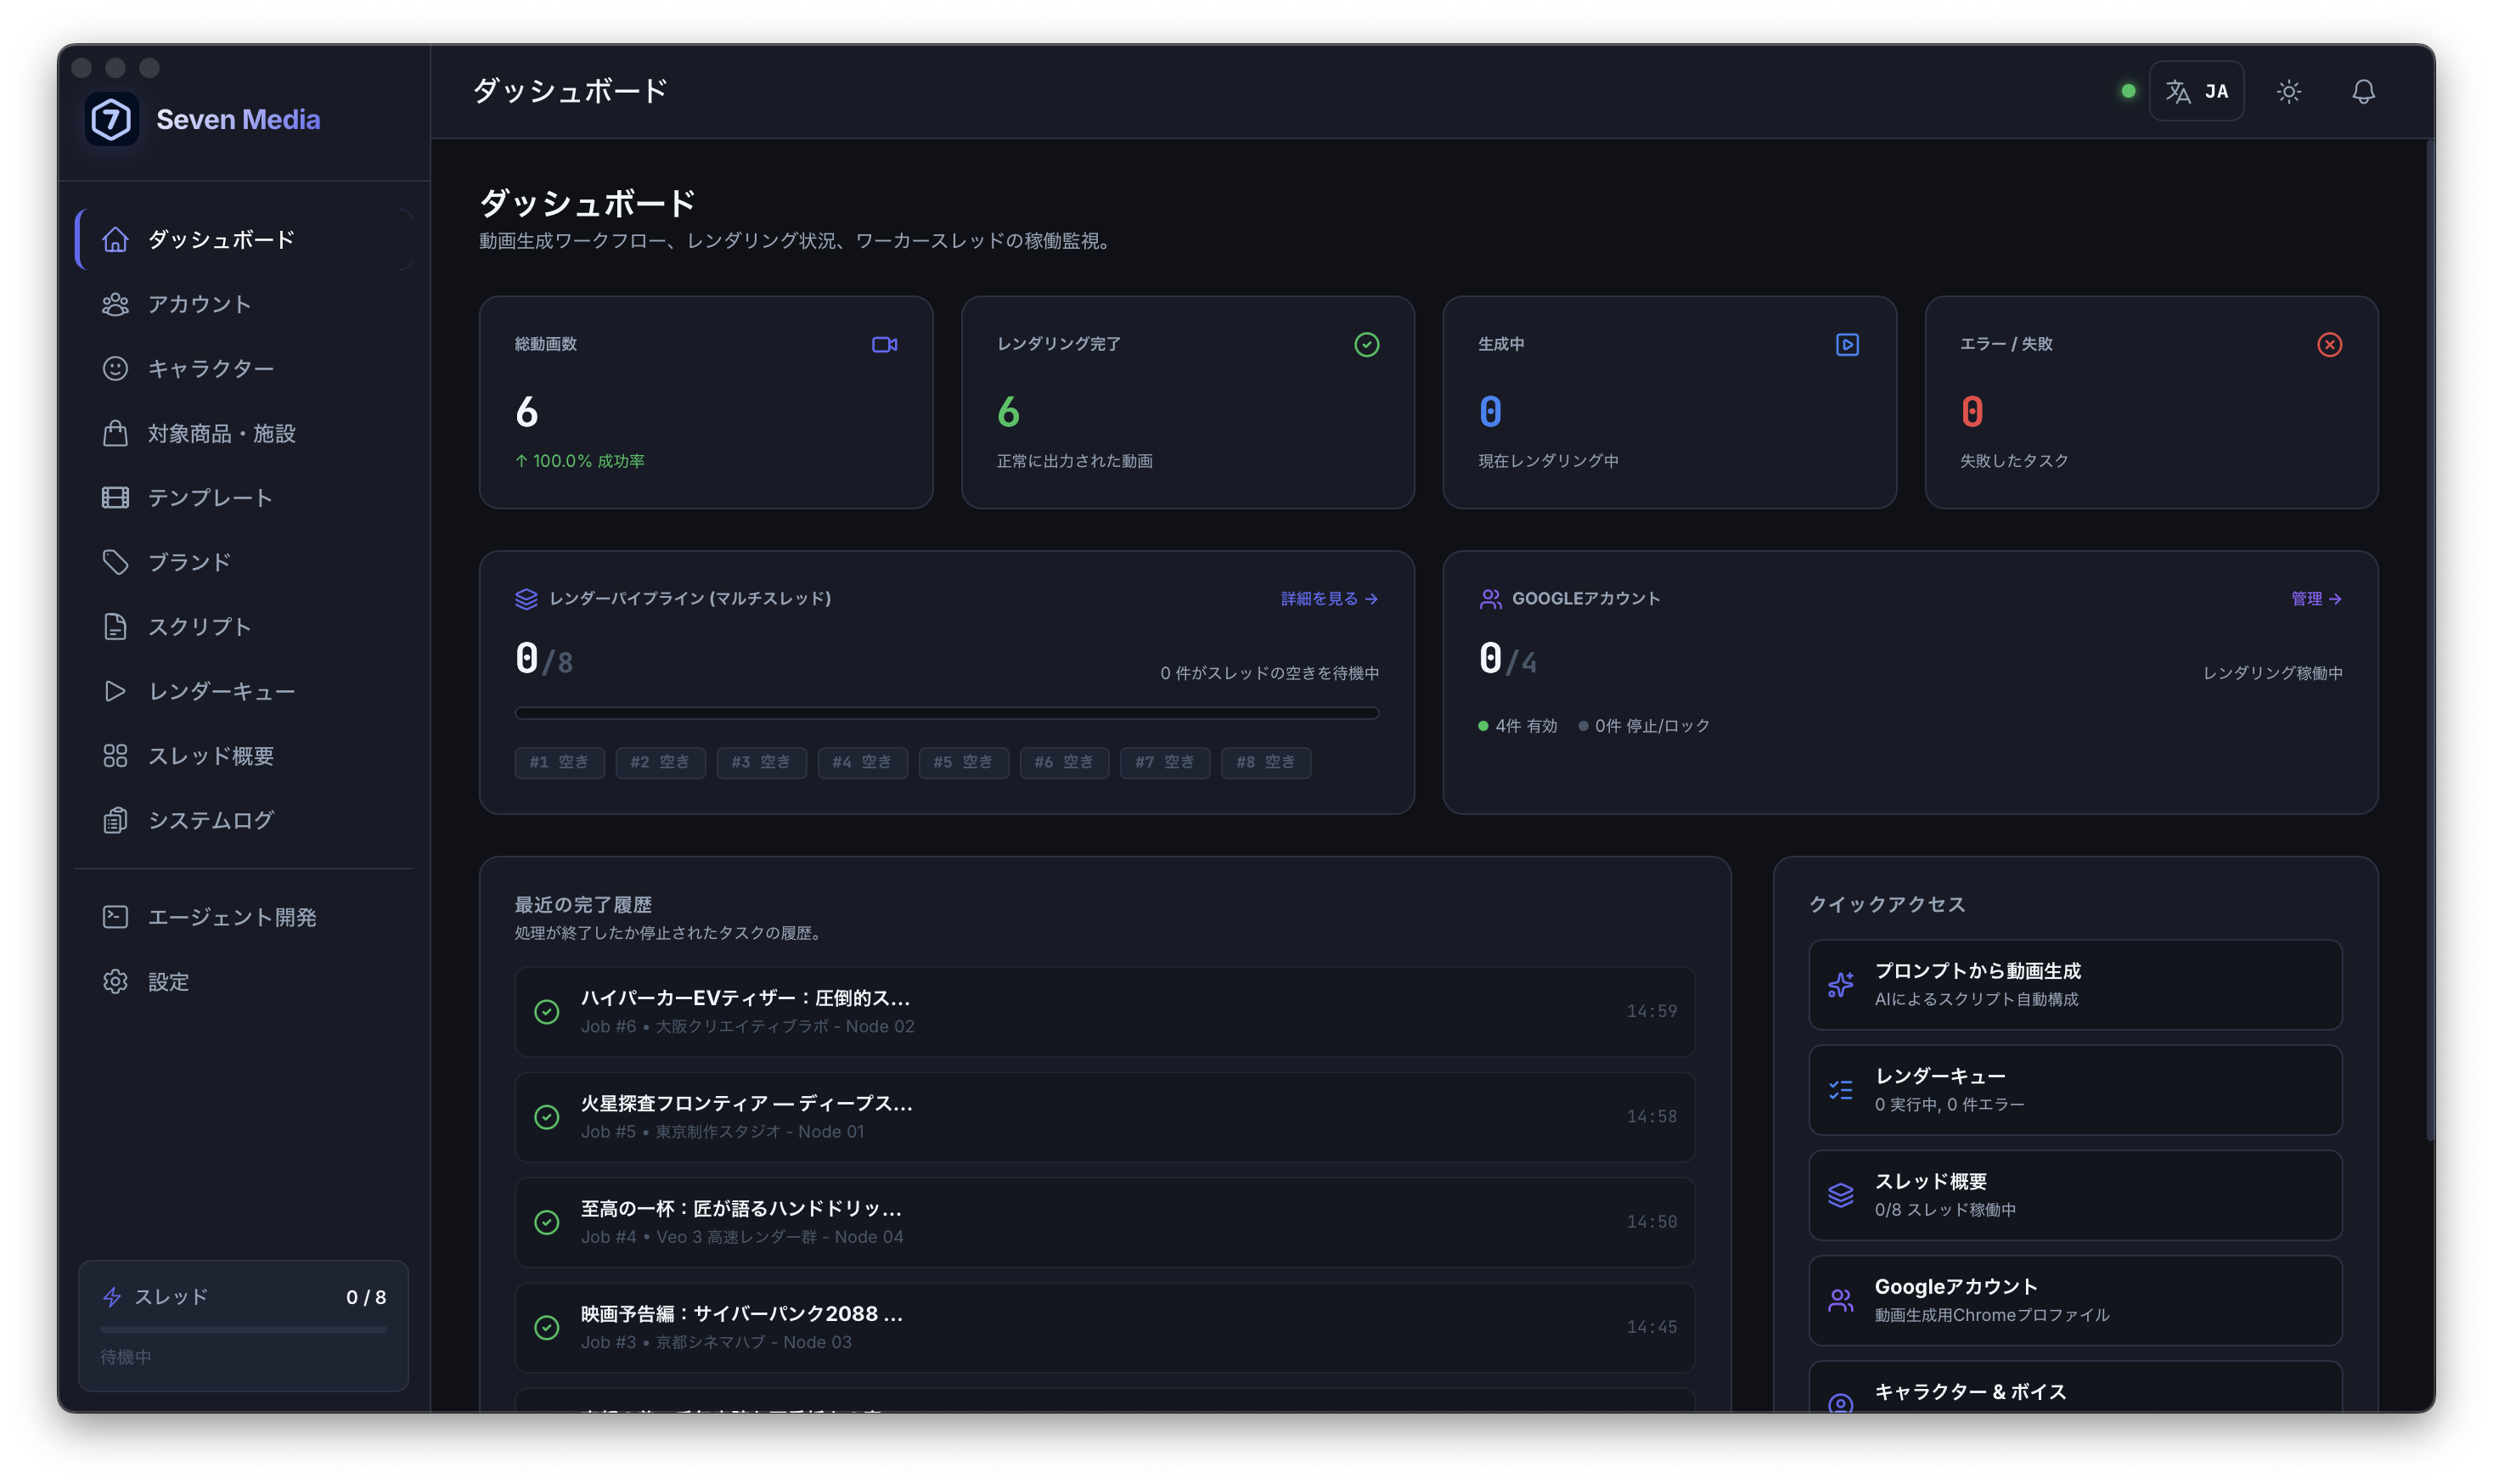
Seven Media Interface
全画面で確認

司令塔:リアルタイム全体パイプライン監視

8〜16本の並列レンダリングスレッド、連携Googleアカウント、進行中の動画タスク、パフォーマンス指標をCPU負荷ゼロで一元監視。

8-16 並行ワーカプール
シーン進行タイムライン
1クリック状況レポート
圧倒的な生産性向上

従来の動画制作から Seven Mediaへ移行すべき理由

時間とコストがかかる従来の手作業と、Seven Mediaの完全自律化パイプラインの決定的な違い。

従来の方法 — 時間とコストの浪費
  • 1本あたり2〜4時間:台本作成、素材探し、タイムラインでの手動カット編集の連続。
  • 高額な外部費用:ナレーターへの依頼費、BGMライセンス料、ストック動画の月額課金。
  • キャラクターの顔崩れ:カットごとに顔や雰囲気が変わり、視聴者の信頼と定着率が低下。
  • 拡張性ゼロ:書き出し中にPCがフリーズし、大量バッチ処理でクラッシュ。
Seven Media — 100% 完全自動化
  • わずか3〜5分:プロンプトやURLを入力するだけで、AIが自動分割・レンダリングまで完結。
  • Google Veo 3の圧倒的描写力:洗練されたカメラワークとウォーターマーク自動除去。
  • 一貫したAIキャスト:キャラクターライブラリが同一人物の顔立ちを完全に維持。
  • 並列マルチワーカエンジン:8〜16スレッド同時生成で、1日に何十本もの動画を量産。
最先端の機能群

次世代クリエイターのための 完全武装

軽量なGo言語+WebKitネイティブ設計により、最大限のレンダリングスループットを実現。

Google Veo 3 & VideoFX 深層統合

Google最高峰の動画生成エンジンをフル活用。台本から映画級プロンプトを自動生成し、透かしのない高画質動画を自動保存。

Camera Movement 60 FPS Smoothness Cinematic Lighting Auto VideoFX Flow

多重並列レンダリングキュー

PCがフリーズすることはもうありません。インテリジェントな負荷分散により、4〜16本のタスクを安定して同時処理。

Parallel Task Dispatcher (16 Max)

多言語対応スタジオ級音声合成

七海、圭太をはじめとする日本語、ベトナム語、英語、韓国語など100種以上の放送品質ボイスを搭載。字幕と音声タイミングを自動調整。

アンチ検出 & プロキシによるアカウント保護

各Googleアカウントを完全独立サンドボックスで稼働。IANAタイムゾーン、ブラウザ言語、SOCKS5/HTTP/PACプロキシに対応。

Timezone Spoofing SOCKS5 / HTTP Proxy PAC Script Routing IP Whitelisting

AIキャラクター一貫性マトリクス

長編シリーズでもキャラクターの顔、性別、年齢、スタイル(アニメ、ちびキャラ、実写3D)を崩さず維持。

完全スタンドアロン — 外部依存ゼロ

ffmpeg、ffprobe、yt-dlpがすべてアプリ本体に内包されています。環境構築やコマンド操作は一切不要で、ダウンロード後すぐに稼働可能です。

Zero External Dependencies Auto-Update 1-Click
自動化フロー

アイデアから完成動画までの 4ステップ

わずか4ステップ。複雑な作業はすべてバックグラウンドで自動処理されます。

01

アイデア / 参考URLの入力

テーマを入力するかYouTube/TikTokの動画リンクを貼るだけで、AIが自動で構成案を作成。

02

シーン分割 & ボイス選定

台本を短いシーンに自動分割し、最適なカメラアングル指定と感情豊かなボイスを割り当て。

03

Veo 3 並列レンダリング

専用プロキシ経由でGoogle Veo 3にタスクを自動投入し、進行状況を自動監視・自動リトライ。

04

自動ポストプロダクション & 4K出力

シーン結合、著作権フリーBGM、おしゃれな字幕を自動合成し、完成MP4ファイルをデスクトップへ保存。

マルチプロバイダー TTS 音声アーキテクチャ

柔軟なTTSライブラリ連携 & 動的API・ボイス設定

単一ベンダーに縛られません。無料のEdge-TTS、ElevenLabs、OpenAI APIから完全オフラインのローカルGPUモデル、自社専用RESTエンドポイントまで柔軟に連携可能です。

標準搭載 • API費用0円

Edge-TTS クラウドニューラル

直接WebSocket接続により超低遅延を実現。100種類以上の高品位ニューラル音声をAPIトークン消費なしで無制限利用可能。

WebSocket WSS < 150ms
スタジオ品質 • 声質複製

ElevenLabs & OpenAI API

個人のAPIキーによるダイレクトREST連携。高精度な音声クローニング、Multilingual v2、感情抑揚の微細調整に対応。

HTTPS REST Stream 48kHz Studio
完全オフライン • 機密保護

ローカルGPUモデル (Kokoro/VITS)

ローカルGPU(CUDA/Apple Silicon MPS)で自立動作。外部通信ゼロのエアーギャップ環境で最高セキュリティを保証。

Local Subprocess IPC 80ms Latency
エンタープライズ • 拡張自在

カスタムREST / Webhook

自社専用TTSサーバーやプライベートマイクロサービスへ直接ルーティング。独自ヘッダー認証およびJSONスキーマに完全対応。

Custom HTTP POST Full Modular
接続完了 • マルチスレッド待機中
WebSocket / WSS < 150ms
バックエンドディスパッチスキーマ (JSON)
{
  "provider": "edge_tts_neural",
  "endpoint": "wss://speech.platform.bing.com/consumer/speech/synthesize/3",
  "voice": "ja-JP-NanamiNeural",
  "rate": "+0%",
  "pitch": "-2Hz",
  "audio_ducking": {
    "bgm_attenuation_db": -24.0,
    "attack_ms": 120,
    "release_ms": 380
  }
}
コンテンツジャンル別プリセット一覧

ジャンル特性に最適化された音声プロファイル & ダッキング制御

長編小説から短尺SNS広告まで、視聴維持率を最大化する最適な声質・抑揚・BGMダッキング深度を自動設定します。

情緒豊か • 余韻重視
小説朗読情緒豊か情景描写

ライトノベル・長編朗読

ENGINE: Edge-TTS: ja-JP-NanamiNeural (Expressive)
CONFIG: 組み込みWebSocket • ピッチ: -1Hz • 語り口調
DUCKING: BGM -26dB (静謐な情景描写と余韻を重視した深めのダッキング)
“静まり返った廃図書館の最深部で、百年間誰の手にも触れられなかった古文書が、微かに青い光を帯びて脈打ち始めた……”
Auto Sidechain -24dB
テンポ良好 • 高明瞭度
YouTube解説明瞭発音情報まとめ

YouTube解説・トレンドまとめ

ENGINE: OpenAI Audio: Shimmer / Edge-TTS: Keita
CONFIG: REST API Stream • 速度: 1.08x • クリア明瞭度
DUCKING: BGM -20dB (軽快なBGMと明確な発声の最適な調和)
“今回のテーマはAI動画制作のパラダイムシフト!なぜ並列レンダリングキューがプロの制作現場で必須とされるのか、仕組みを3分で解説します。”
Auto Sidechain -24dB
劇的表現 • ローカルGPU
キャラクター劇感情演出アニメ風

アニメ・ゲームキャラクター劇

ENGINE: ローカルGPU (Style-Bert-VITS2 / VOICEVOX)
CONFIG: Local Subprocess IPC • 感情パラメータ制御
DUCKING: BGM -18dB (効果音とセリフのダイナミック連動制御)
“覚悟はいい?これが私たちの最初で最後のチャンス。どんなに暗い未来でも、私が絶対に道を切り拓いてみせるから!”
Auto Sidechain -24dB
信頼感 • 標準アクセント
企業VP標準アクセントプレゼン

ビジネス・製品プレゼンテーション

ENGINE: Edge-TTS: ja-JP-NanamiProfessional
CONFIG: 組み込みWebSocket • 標準アクセント • 落ち着いたトーン
DUCKING: BGM -24dB (誠実さと高い信頼感を演出するナレーション優先)
“Seven Mediaは自律型ワークフローエンジンを搭載し、従来の動画制作にかかる外注コストと制作工数を最大90%削減します。”
Auto Sidechain -24dB
重厚感 • シネマティック
ドキュメンタリー重厚な低音歴史解説

ドキュメンタリー・歴史解説

ENGINE: ElevenLabs: Japanese Neural v2 (Deep Baritone)
CONFIG: REST API • 安定性: 0.70 • 低音強調イコライザ
DUCKING: BGM -26dB (重厚なストリングスと調和する重低音響)
“千年の風雪を耐え抜いた石造りの遺構は、いまも語られることのない古代の記憶を、沈黙の底で静かに宿し続けている……”
Auto Sidechain -24dB
冒頭3秒インパクト • 離脱防止
SNSショート離脱防止TikTok/Reels

SNSショート広告・リール

ENGINE: カスタムREST / ElevenLabs Turbo
CONFIG: http://localhost:8880/v1/tts • 速度: 1.15x
DUCKING: BGM -17dB (冒頭3秒の離脱防止アタック型ダッキング)
“まだ1本の動画編集に丸一日かけてるの?テキストを入力するだけで4K完成動画が自動生成される最新ツールがこちら!”
Auto Sidechain -24dB
機能比較表

Seven Mediaと 他社ソリューションの比較

主要機能・性能 Seven Media 一般的なWebクラウド 手作業(Premiere/CapCut)
動画生成エンジン Google Veo 3 シネマティック 旧型AI / 透かし付与 素材の手動検索・購入
並列処理能力 8〜16スレッド同時並行 単一ジョブ(サーバー待機) 1本ずつ順次編集
Googleアカウント保護 アンチ検出+専用プロキシ 共有IPによる凍結リスク 保護機能なし
音声合成&字幕同期 100%完全自動(Edge-TTS) 高額なクレジット課金 手動タイピング入力
1本完成までの所要時間 3〜5分 15〜30分 2〜4時間
スタジオを無料体験

スタジオの圧倒的パワーを無料体験 — 今すぐダウンロード

クレジットカード不要、事前の購入義務もありません。デスクトップに直接ダウンロードし、Google Veo 3 を活用した完全自動AI動画制作パイプラインを今すぐご体験ください。

環境構築不要

完全スタンドアロン 自己完結設計

ffmpeg、ffprobe、yt-dlp を内蔵した自己完結型バイナリ。Python やコマンドライン設定は不要で、起動するだけで即座に動作します。

  • macOS DMG & Windows EXE 専用インストーラー
  • 超低メモリ消費のネイティブ高速パフォーマンス
  • Apple Silicon & Intel / x64 アーキテクチャ自動判別
全機能解放
全機能解放

完全自動化 パイプライン解放

最大16並列のレンダリングキュー、AI脚本自動分割、ウォーターマーク自動除去、100種超の感情音声合成の全機能をお試しいただけます。

  • 最大16ワーカーの高速並行レンダリング
  • 顔の特徴を固定するAIキャラクター一貫性マトリクス
  • ナレーション時BGM自動ダッキング & 放送品質音声
完全ローカル保護

ローカルサンドボックス 完全プライバシー

作成した脚本、Googleアカウント情報、書き出された4K動画はすべてPC内に安全に保持されます。外部クラウドへの情報漏洩はありません。

  • SOCKS5プロキシ対応の完全独立アカウントプロファイル
  • IANAタイムゾーン、言語ヘッダー、解像度の偽装
  • 外部テレメトリ送信ゼロ:制作資産の完全保護

完全無料ダウンロード • クレジットカード不要 • 起動後すぐに利用可能

よくあるご質問

Seven Mediaに関する 疑問をすべて解決

動画制作の生産性を 劇的に変革しませんか?

今すぐSeven Mediaをダウンロードして、次世代の完全自動化動画制作を体感してください。